RAG已死
在AI应用开发领域,时常会遇到一种困境:一个在演示中表现出色的原型,在迈向生产环境的过程中会暴露出一系列难以预测和修复的问题。工程师投入大量精力进行“调优”,但整个过程往往缺乏系统性的指导,更像是一种经验性的试错。
最近,Chroma创始人Jeff Huber在一期播客中的分享,为我一直以来的困惑提供了一个清晰且具有启发性的思辨框架。
它不提供捷径,而是回归到更基本、更核心的工程原则。以下是我梳理出的6个观察,希望能为同样在探索中的你带来一些参考。
1. 核心挑战:跨越从Demo到“生产级可靠”的鸿沟
一个普遍的现象是,用现有框架构建一个RAG Demo非常迅速。但这种初期的便捷,往往掩盖了通往 “生产级可靠系统”(Production Reliable System) 的复杂性。
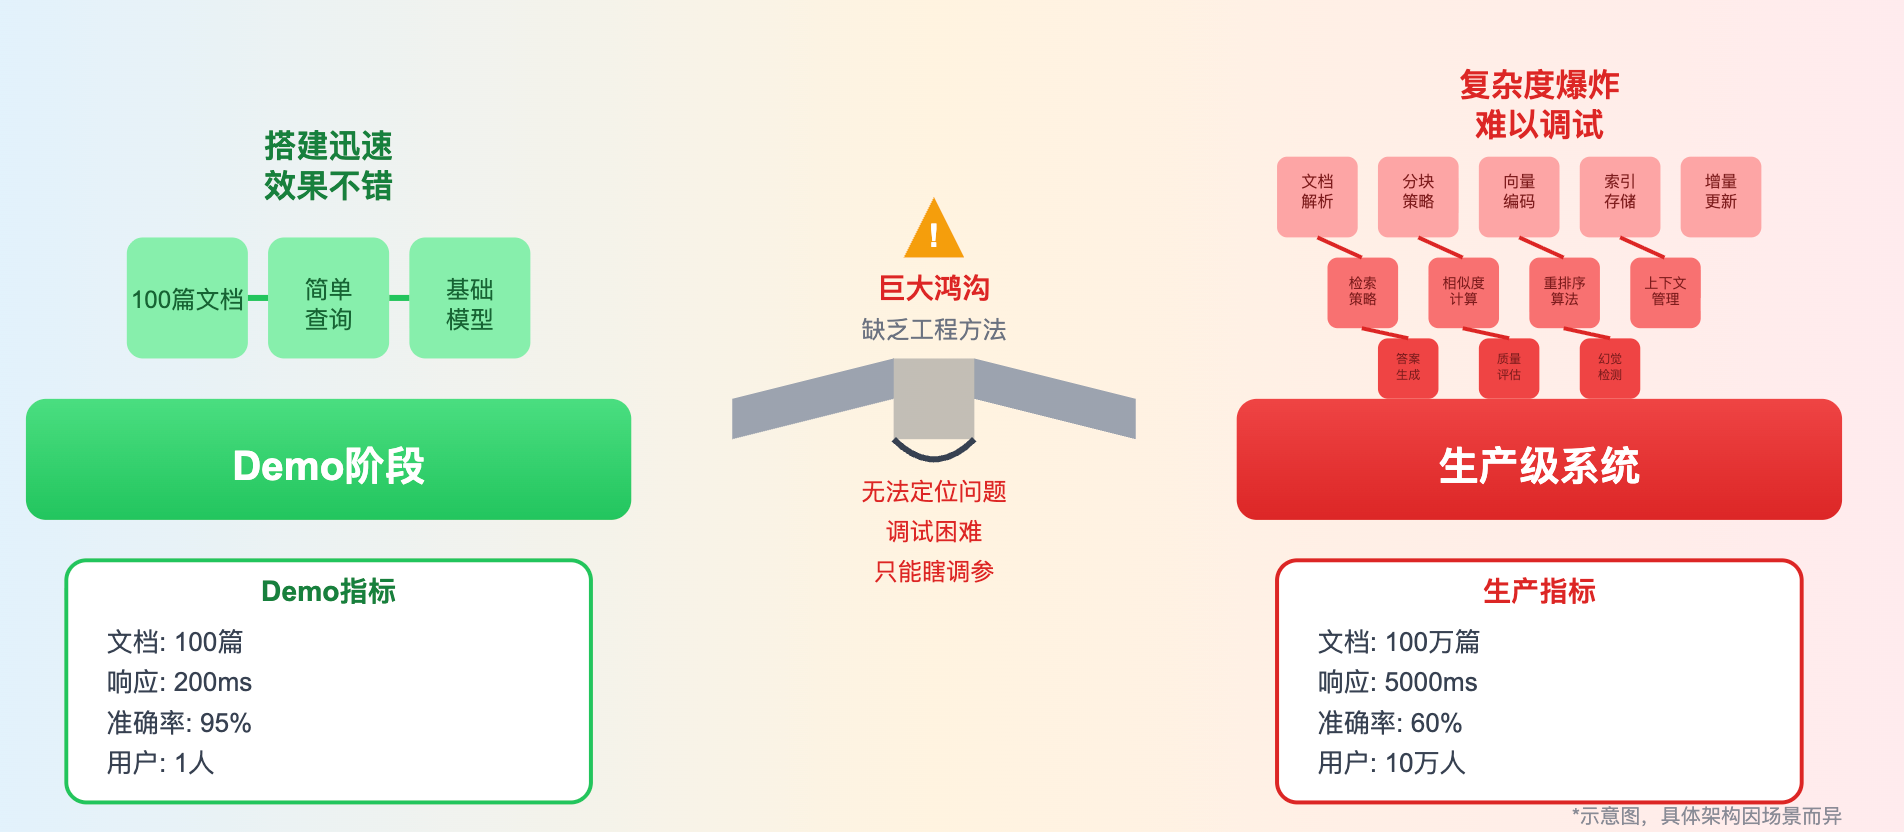
_RAG系统工程化鸿沟示意图_
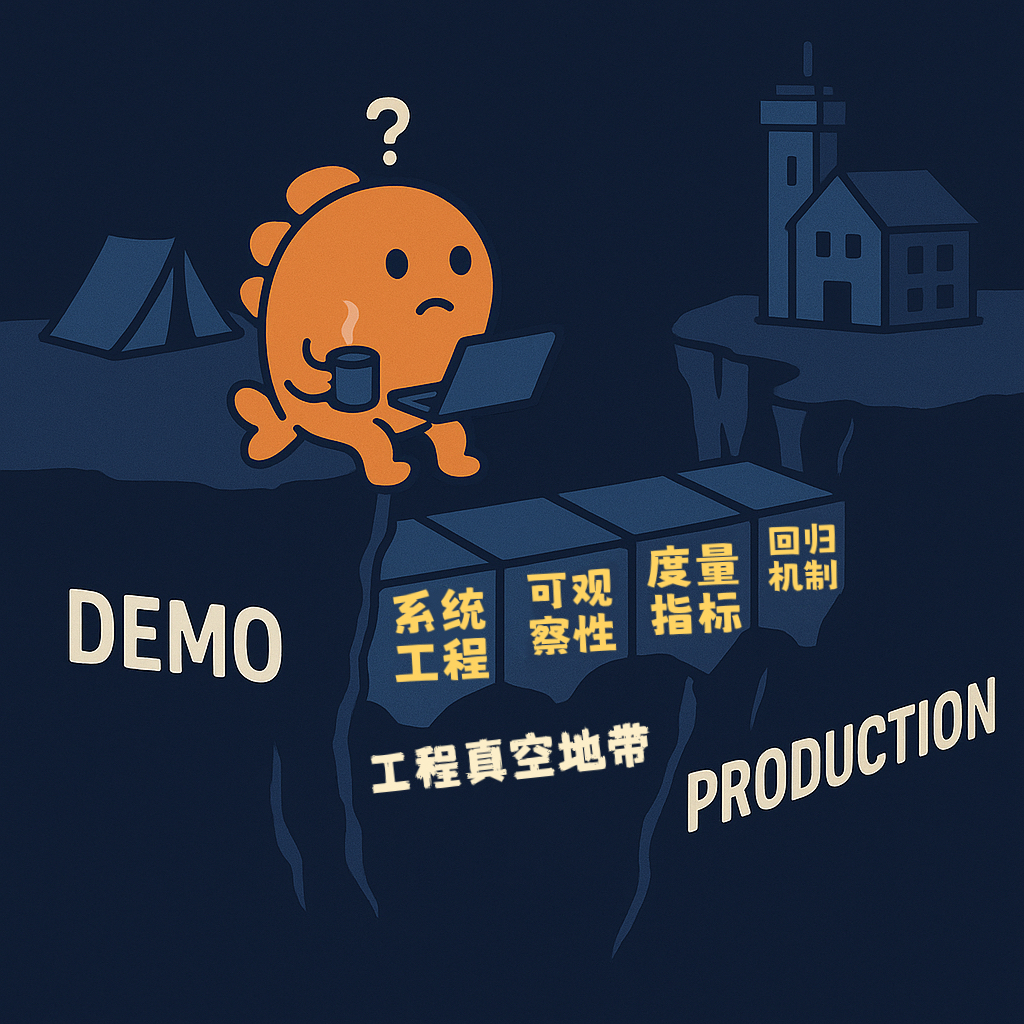
Jeff Huber认为,我们当前许多看似是“调参”的工作,其本质是在弥补这道鸿沟。之所以感觉像“炼金术”,根源在于我们缺少一套可度量的、系统化的工程方法论。当系统表现不符合预期时,我们无法对问题进行归因和定位,只能依赖经验进行调整。
摸鱼观察: 这并非AI领域的特有问题,而是任何新技术从诞生走向成熟的必经之路。软件工程的发展史,很大程度上就是用工程的确定性去约束和管理创新的不确定性。承认这道鸿沟的存在,并主动寻求工程化的解决方案,是走向成熟的第一步。
2. “上下文腐烂”揭示了模型认知能力的边界条件
业界对“长上下文窗口”的追求,源于一种直观的假设:输入的信息越多,模型的能力就越强。
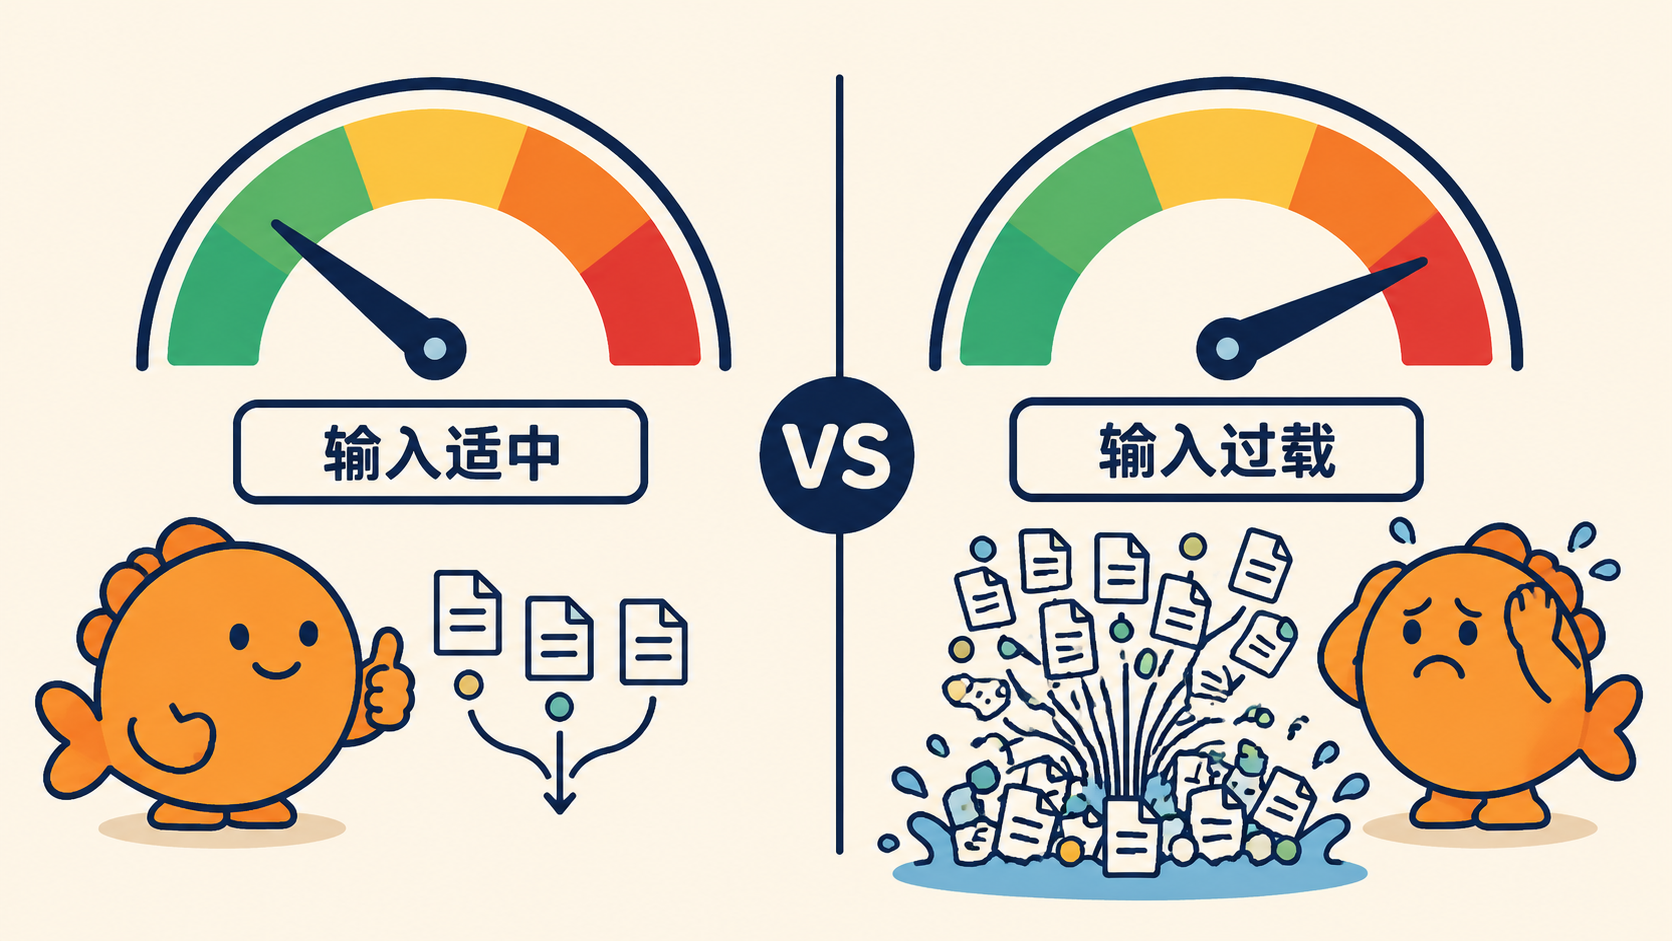
然而,“上下文腐烂”(Context Rot) 这一概念,揭示了模型认知能力与其输入信息量之间,存在一种微妙的非线性关系。当信息输入超过某个阈值后,模型的关键能力——如精确遵循指令和进行复杂推理——可能会被过量、低信噪比的信息所稀释,出现性能衰减。
目前流行的“大海捞针”测试,主要验证了模型的“信息召回(Recall)”能力,但一个可靠的应用,更依赖于模型在适量、精确上下文中的“推理与执行(Reasoning & Execution)”能力。
摸鱼观察: 这促使我们从“信息量的堆砌”转向“信息质量的管理”。评估一个模型,或许不应只看其上下文窗口的上限,更要关注其在不同上下文长度下的性能稳定性。对于应用开发者而言,我们的任务不是测试模型的极限,而是在其性能的“甜点区”内进行高效的工作。
3. 开发者的角色,正从“模型使用者”演进为“认知系统设计师”
Jeff Huber提出的“上下文工程”(Context Engineering),不仅是一个新术语,更暗示了开发者角色的转变。
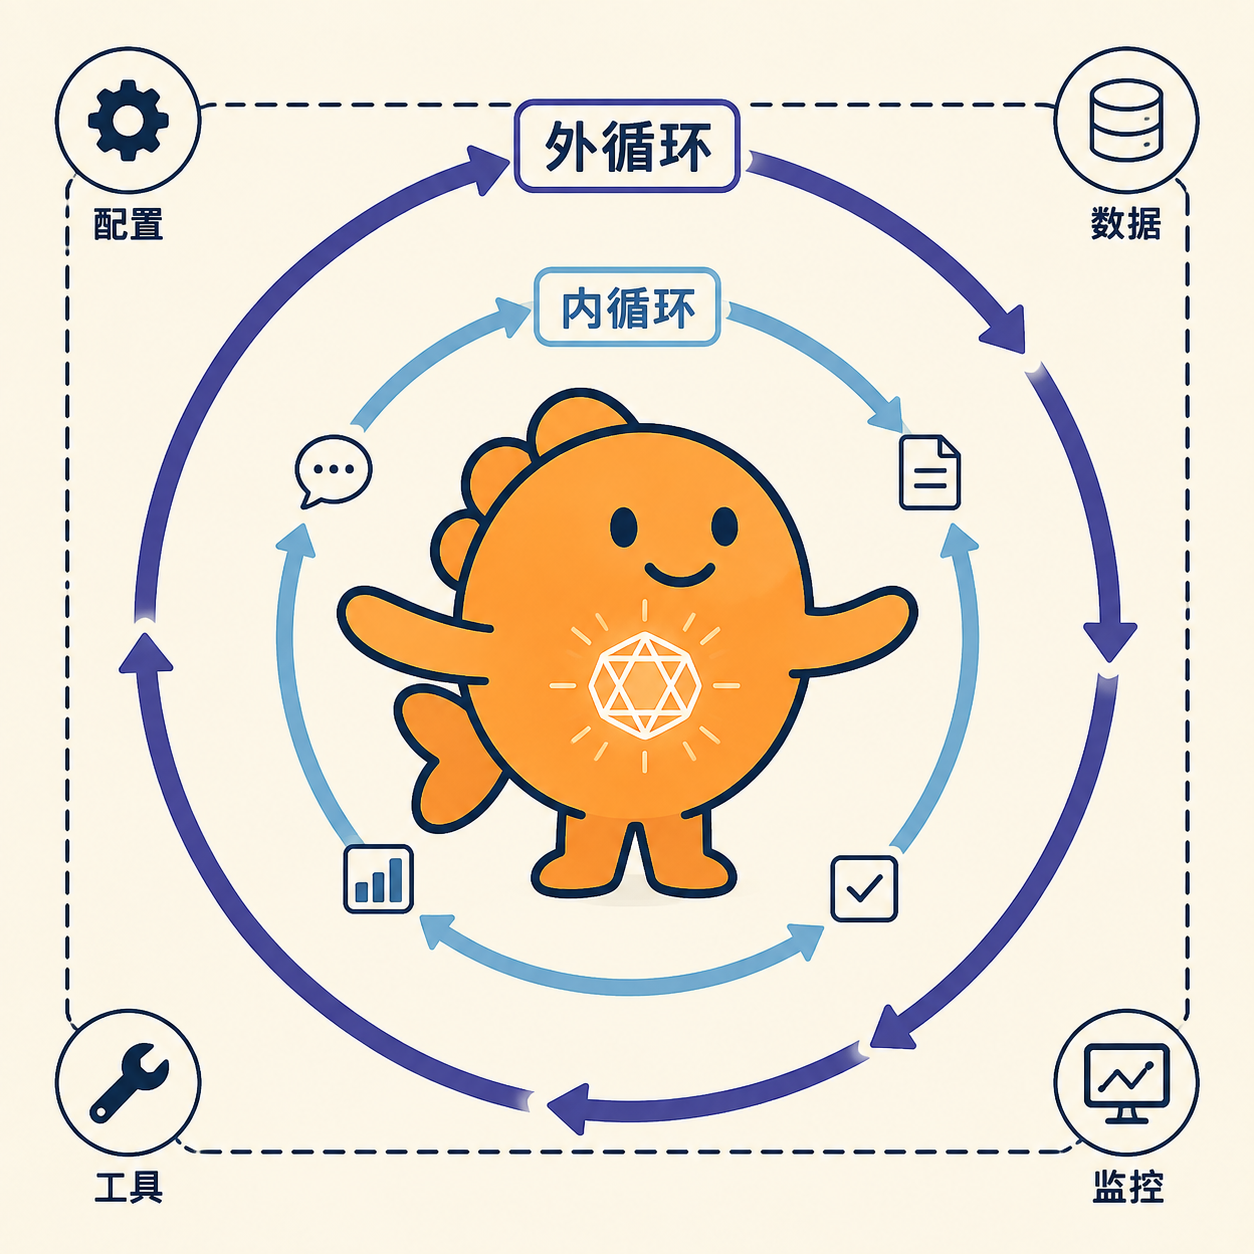
其“内外双循环”的框架,实际上是在为AI系统设计一套“认知新陈代谢”的机制:
- 内循环: 关注单次交互中的信息流转与处理,是系统的“实时响应层”。
- 外循环: 关注系统的长期演进与自我优化,是系统的“策略迭代层”。
摸鱼观察: 在这个框架下,开发者的重心不再是如何写出更巧妙的提示(Prompt),或是如何集成某个模型API。我们的核心工作,是设计和构建一个能让模型持续、稳定、高效工作的外部系统环境。我们正从单纯的“模型使用者”,转变为一个更综合的“认知系统设计师”。
4. 现代AI检索是一种架构模式,而非单一工具的选择
关于检索,我们的讨论常陷入“哪个向量数据库更好”或“哪种算法更优”的工具层面。
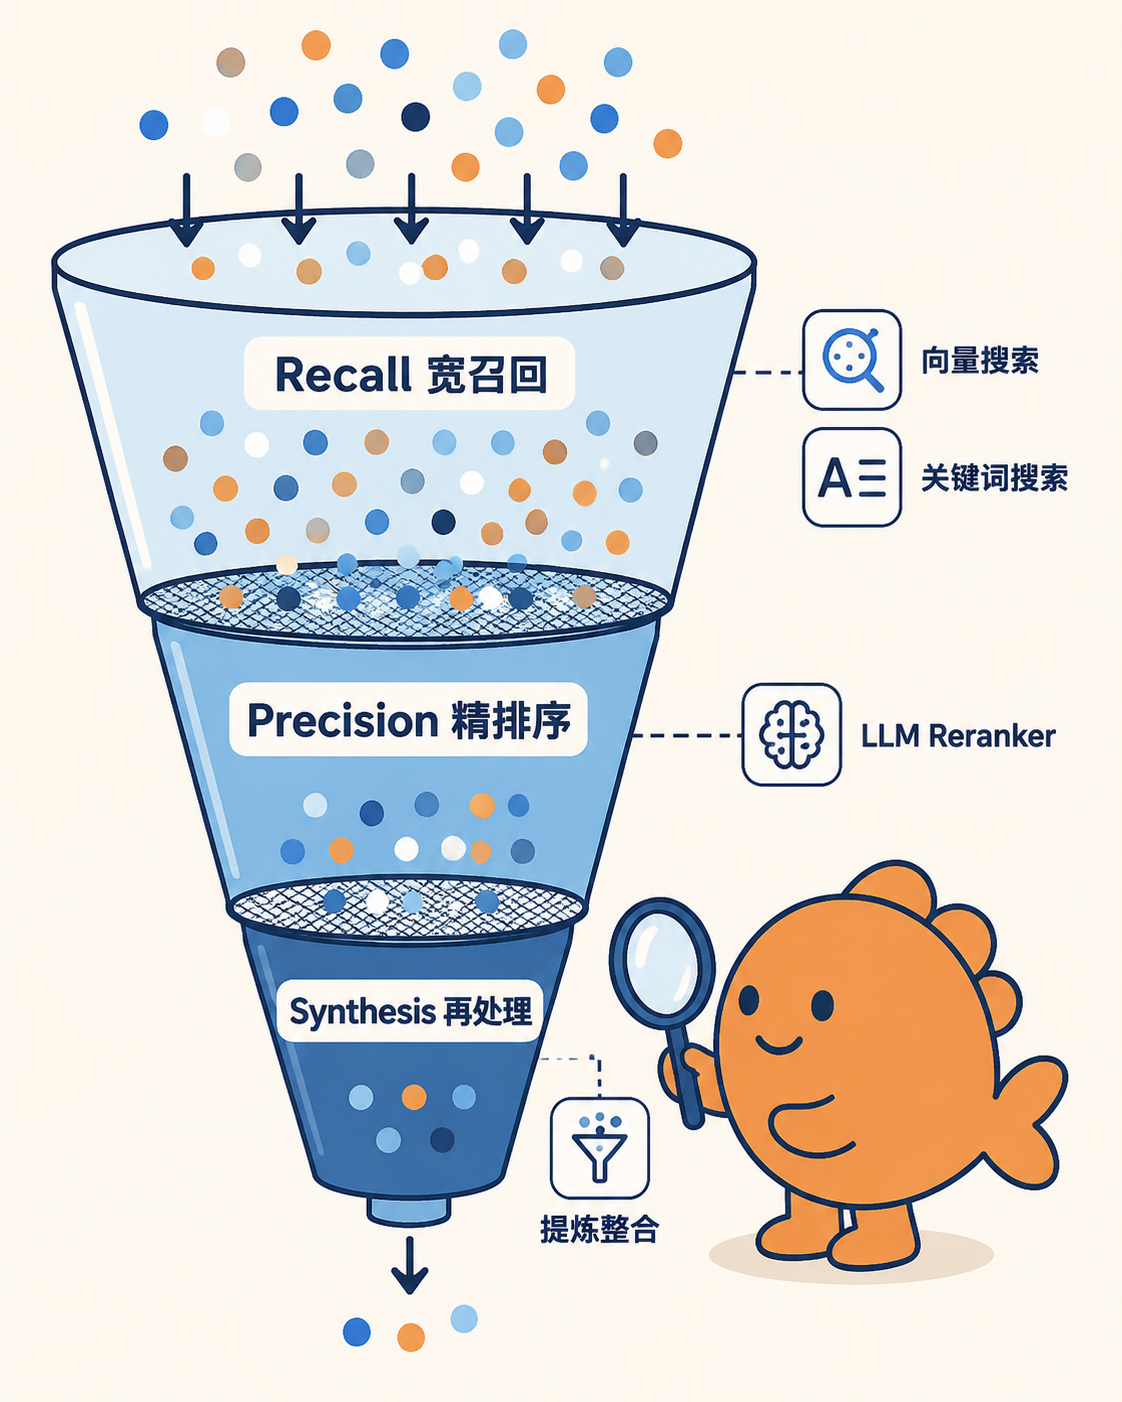
一个更具深度的视角,是将其理解为一种“信息筛选漏斗”(The Retrieval Funnel)的架构模式。这个模式的核心,是通过分层设计,在系统的成本、延迟和质量三者间取得平衡。
- 宽召回层(Recall): 使用成本较低的计算(如向量、关键词混合搜索),保证候选集的全面性。
- 精排序层(Precision): 使用成本较高的计算(如LLM Reranker),提升最终上下文的准确性。
- 再处理层(Synthesis): 对信息进行最终的提炼与整合,保证其可用性。
摸鱼观察: 这种分层漏斗的架构思想,在现代软件工程中随处可见(例如,多级缓存、CDN网络)。将其应用于AI检索,意味着我们开始将这个模块作为系统的一个有机组成部分进行设计,而不仅仅是一个外部依赖。LLM本身,也正从一个“终点”的角色,下沉为这个架构中一个可被调度的“计算组件”。
5. “黄金数据集”是引入“经验主义”工程方法论的基石
工程学科区别于手工艺的核心,在于其依赖可度量的、经验性的改进。在AI应用中,我们常常缺少这样一个客观的“度量衡”。
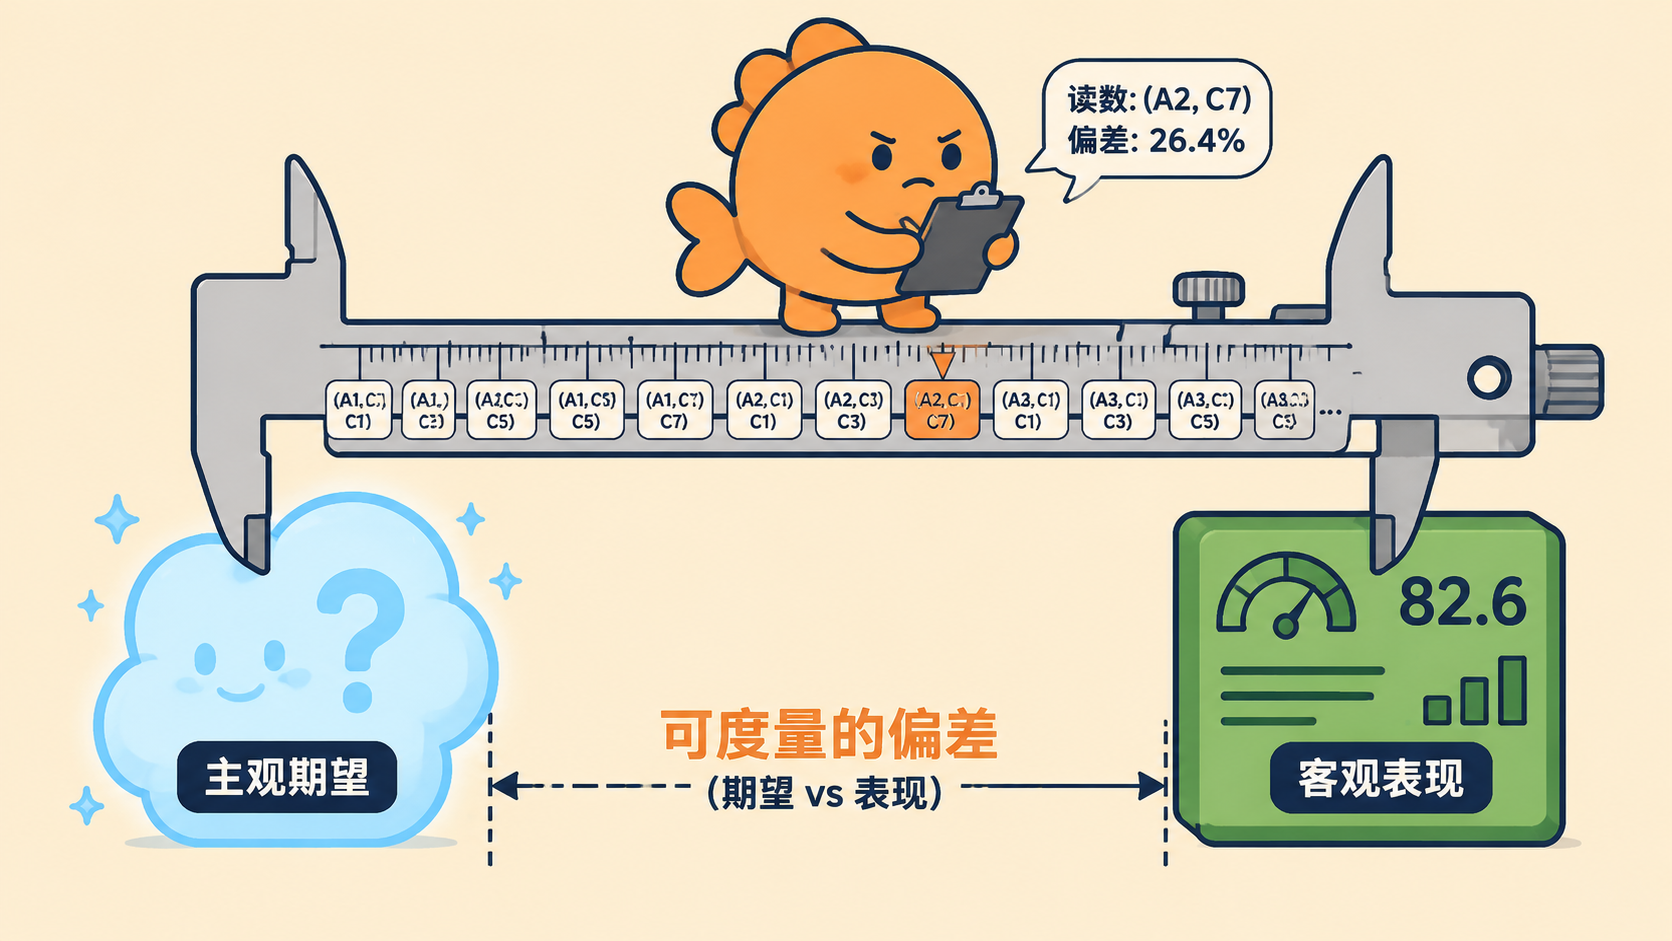
“黄金数据集”(Golden Dataset)正是这个度量衡的载体。它的价值不在于大小,而在于它为团队提供了一个稳定的客观基准,用以锚定对“好”的主观判断。
有了这个基准:
- 任何对系统的改动,其效果都可以被量化评估,从而使迭代有章可循。
- 生成式基准测试(Generative Benchmarking)等方法的出现,也使得从零开始构建这个基准的难度大大降低。
摸鱼观察: 这本质上是在AI开发中引入“测试驱动开发”(TDD)和“经验主义过程控制”(Empirical Process Control)的思想。它要求我们从对算法的盲目信仰,回归到对可观测、可度量结果的尊重。这是让AI开发回归工程本质的关键一步。
6. “记忆”是“解耦架构”下,对“状态管理”的一种高级抽象
我们都希望AI拥有“记忆”,但“记忆”本身是一个模糊的拟人化概念。从系统设计的角度看,Jeff Huber提供了一个更锐利的解释。
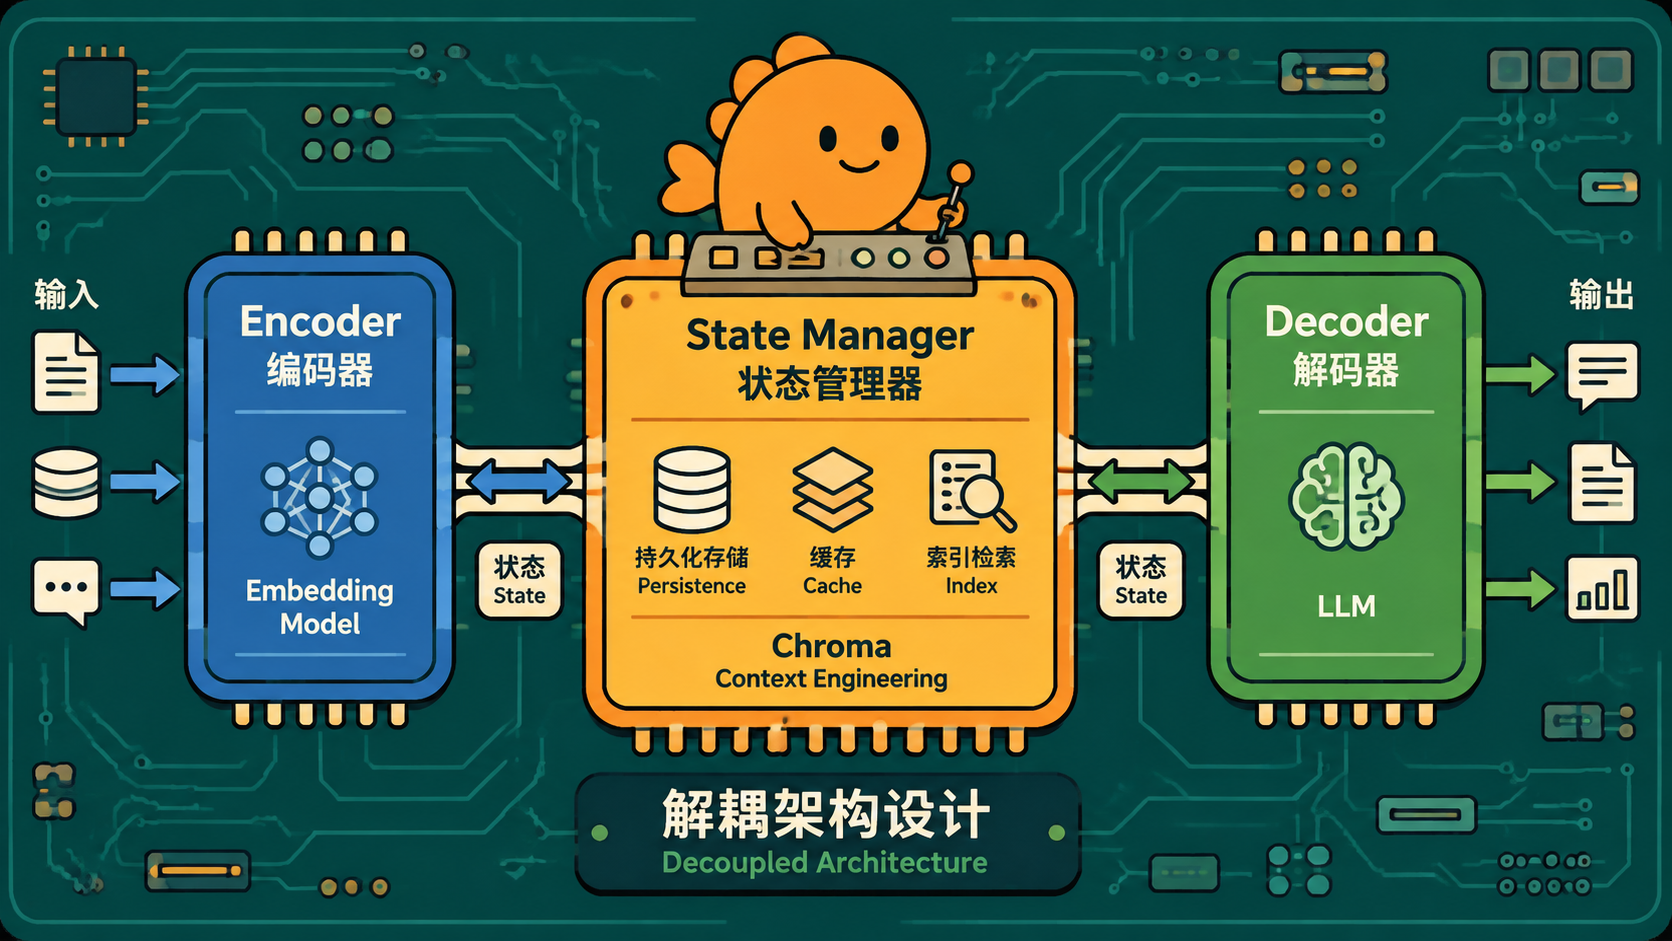
他提出了一个值得思考的架构假说:我们可能正在构建一个“宏观解耦的Transformer”系统。
- 外部编码器(Embedding Models) 负责信息压缩。
- 外部解码器(LLMs) 负责推理生成。
- 上下文工程系统(如Chroma)则在中间扮演了“状态管理器”(State Manager) 的角色。
所谓的“记忆”,正是对这个中间层所管理的、可持久化、可检索的“状态”的一种高级抽象。它将一个模糊的AI概念,映射到了一个经典的、我们所熟知的工程问题上:状态管理。
摸鱼观察: 这个视角极具启发性。它将我们的任务,从“如何为AI实现记忆”,重新定义为 “如何为解耦的AI架构设计一个高性能、可扩展的状态管理层” 。这不仅让问题变得更清晰,也为我们借鉴数十年来在数据库和分布式系统领域积累的经验,打开了大门。
配图清单
说明:正文第1节已有2张真实配图(从demo到生产的巨大鸿沟),第2-6节此前以"[配图建议]"文字形式留了创意草稿,这里统一整理为标准配图清单格式,方便逐一生成。只有封面图是全新缺项。
00-cover.png
位置:
frontmatter(文章封面)
比例要求:
21:9 或 2:1,至少 1600×900
用途:
封面图 / 分享卡片
类型:
概念插画
主题:
从Demo到生产级可靠系统之间的巨大工程鸿沟——呼应正文第1节已有的"鸿沟"意象,但用于封面需要更简洁、更具氛围感的构图。
画面描述:
- 主体对象:画面左侧是一个轻巧漂浮的"Demo"气泡/原型图标,右侧是一座坚实、有结构的"生产系统"建筑轮廓,中间是一道明显的裂谷/鸿沟
- 空间关系:左轻右重,中间裂谷是视觉焦点
- 动作:无明显动作,强调静态的"跨越前"状态
- 情绪:略带警示感,但整体克制、专业
- 视觉隐喻:轻盈的原型 vs 扎实的工程结构
- 重要元素:不需要复刻正文里已有配图的具体构图,可用更抽象的几何形式表达"鸿沟"这一主题
构图要求:
- 主体位置:居中,鸿沟在正中央
- 留白区域:四周留白,避免关键结构被裁剪
- 横向还是纵向:横向
不要出现:
- UI截图
- 复杂信息
- 文字
02-instrument-dashboard.png
位置:
第2节"'上下文腐烂'揭示了模型认知能力的边界条件"末尾
比例要求:
4:3
用途:
正文
类型:
概念插画
主题:
上下文长度适中 vs 过载时,模型推理与指令遵循能力的非线性衰减。
画面描述:
- 主体对象:一个精密仪器仪表盘,分左右两种状态展示(可做成左右分屏或同一仪表盘的两个时刻)
- 空间关系:左侧输入信号适中,指针稳定指向绿色区域;右侧输入信号过载,指针剧烈摆动指向黄/红警告区
- 动作:指针的摆动幅度体现状态变化
- 情绪:写实、精密,带一点警示感
- 视觉隐喻:信息量堆砌 vs 信息质量管理
- 重要元素:仪表盘上需要标注"推理能力""指令遵循度"等指针标签,否则读者无法理解指针具体代表什么
构图要求:
- 主体位置:左右对比布局
- 留白区域:中间留白分隔
- 横向还是纵向:偏方形
不要出现:
- UI截图
- 复杂信息(避免仪表盘上出现过多无关刻度)
03-vitruvian-core.png
位置:
第3节"开发者的角色,正从'模型使用者'演进为'认知系统设计师'"末尾
比例要求:
4:3
用途:
正文
类型:
概念插画
主题:
达芬奇维特鲁威人的极简改编——中心从人体换成AI核心,外围方圆换成内外循环架构。
画面描述:
- 主体对象:维特鲁威人经典的圆形+方形构图线条保留,但中心的人体替换为一个几何化的"AI Core"图标
- 空间关系:内圈的圆代表"内循环"(实时响应层),外圈的方代表"外循环"(策略迭代层)
- 动作:无
- 情绪:现代、极简主义的设计图纸感
- 视觉隐喻:从"模型使用者"到"认知系统设计师"的角色升级
- 重要元素:内圈和外圈需要标注"内循环"/"外循环"文字标签,因为这是概念图,读者需要区分两个循环分别对应什么
构图要求:
- 主体位置:居中,同心对称
- 留白区域:四周留白
- 横向还是纵向:偏方形
不要出现:
- UI截图
- 复杂信息
04-retrieval-funnel.png
位置:
第4节"现代AI检索是一种架构模式,而非单一工具的选择"末尾
比例要求:
16:9
用途:
正文(流程图)
类型:
流程图
主题:
检索系统的三层漏斗架构:宽召回→精排序→再处理。
画面描述:
- 主体对象:一个三层透明玻璃漏斗,数据点从顶部大量无序进入,逐层减少并变得有序
- 空间关系:自上而下三层依次收窄
- 动作:数据点流动、逐层过滤、最终少量精炼数据点滴落
- 情绪:干净、透明的玻璃质感,有动态流动感
- 视觉隐喻:成本、延迟、质量的三层平衡
- 重要元素:三层需要标注"Recall Layer""Precision Layer""Synthesis Layer"文字标签,否则读者无法区分每层对应的功能
构图要求:
- 主体位置:居中,纵向漏斗
- 留白区域:上下留白
- 横向还是纵向:整体画布横向,内部漏斗结构纵向
不要出现:
- UI截图
- 复杂信息
05-caliper-benchmark.png
位置:
第5节"'黄金数据集'是引入'经验主义'工程方法论的基石"末尾
比例要求:
4:3
用途:
正文
类型:
概念插画
主题:
黄金数据集作为校准"主观期望"与"客观表现"的度量衡。
画面描述:
- 主体对象:一把精密的工业校准卡尺,两端分别夹住两个抽象图标——一端是"主观的用户期望"(云朵/问号形状),另一端是"客观的系统表现"(数据条形状)
- 空间关系:卡尺横向展开,两端图标对称
- 动作:卡尺处于测量/夹紧的静态瞬间
- 情绪:写实、精密的工业设计风格
- 视觉隐喻:用可度量的基准锚定主观判断
- 重要元素:卡尺刻度上可标注"(Query, Context)"字样,暗示黄金数据集由这些数据对组成
构图要求:
- 主体位置:横向居中
- 留白区域:上下留白
- 横向还是纵向:偏方形
不要出现:
- UI截图
- 复杂信息
06-decoupled-circuit.png
位置:
第6节"'记忆'是'解耦架构'下,对'状态管理'的一种高级抽象"末尾
比例要求:
16:9
用途:
正文(流程图)
类型:
流程图
主题:
"记忆"本质上是解耦认知架构中的状态管理层。
画面描述:
- 主体对象:一个电路板风格的极简架构图,三个模块——Encoder(左)、State Manager(中)、Decoder(右)
- 空间关系:State Manager 居中,通过清晰的数据总线连接左右两个模块
- 动作:数据沿总线在三个模块间流动
- 情绪:现代电子工程蓝图风格
- 视觉隐喻:把"记忆"这个拟人化概念还原为经典的状态管理问题
- 重要元素:三个模块必须标注"Encoder""State Manager""Decoder"文字标签,整个图可用虚线框标注"Decoupled Cognitive Architecture"
构图要求:
- 主体位置:居中,三模块横向排列
- 留白区域:上下留白
- 横向还是纵向:横向
不要出现:
- UI截图
- 复杂信息